HAProxy 在KaiwuDB 中的最佳实践
介绍
HAProxy 是一个高性能开源 TCP/HTTP 负载均衡器,支持四层(L4)与七层(L7)代理,具备负载均衡、健康检查、故障转移、会话保持等能力,广泛用于数据库等场景的高可用架构中。
KaiwuDB 分布式集群由多个节点组成,客户端直接连接任意节点均可访问数据库,但在生产环境中直接连接节点存在以下问题:
- 客户端需维护多个节点地址,接入方式不统一;
- 节点故障时客户端无法自动切换,影响业务连续性;
- 多节点间连接无法按负载均衡分发,容易出现热点节点。
通过 HAProxy 将集群各节点的 SQL 端口统一代理到同一入口,可以解决上述问题:
- 统一入口:客户端只需连接 HAProxy 地址,无需感知集群内部节点拓扑;
- 负载均衡:支持
leastconn、roundrobin、source等多种算法,将连接均匀分发到各节点; - 故障转移:自动健康检查剔除故障节点,节点恢复后自动纳入服务;
- 会话保持:支持基于源 IP 的会话粘性,保证同一客户端始终访问同一节点;
- 流量治理:通过多个
listen端口实现读写分离,将写入与查询流量分层管理。
::: Notes 说明 基于 HAProxy 2.0.33 验证,高版本(2.4+、2.6+)语法向下兼容;更多个性化配置可参考官方文档 HAProxy version 2.0.28 - Configuration Manual :::
环境要求
硬件
HAProxy 仅做四层转发,不承担数据库计算,资源占用较低,但需根据集群规模与 maxconn 预留足够资源:
| 资源 | 最低要求 | 推荐配置 | 说明 |
|---|---|---|---|
| CPU | 2 核 | 4 核及以上 | nbthread 建议等于 CPU 物理核数 |
| 内存 | 2 GB | 4 GB 及以上 | 与 maxconn 相关,单连接约占用 1~4 KB,连接数越大内存占用越高 |
| 磁盘 | 10 GB | 50 GB 及以上 | 用于系统与 HAProxy 日志(高并发场景 log 增长较快) |
| 网卡 | 千兆 | 万兆 | 高压力写入场景建议万兆网卡 |
软件
| 软件 | 版本要求 | 说明 |
|---|---|---|
| 操作系统 | Ubuntu 18.04+ / CentOS 7+ / openEuler 等 Linux 发行版 | 本文以 Ubuntu 为例 |
| HAProxy | 2.0.33+ | 本文配置基于 2.0.33 验证,高版本兼容 |
| socat | 建议安装 | 通过 Unix socket 实时查看 HAProxy 状态(show stat、show servers state 等) |
| 编译依赖 | gcc、make、libpcre2-dev、libssl-dev、zlib1g-dev、libsystemd-dev | 仅源码编译安装时需要 |
使用方法
安装
以ubuntu系统为例:
通过apt进行安装
# 1. 更新本地软件包索引
sudo apt update

# 2. 一键安装 HAProxy
sudo apt install -y haproxy

# 3. 验证安装与版本
haproxy -v
源码编译安装
# 拉取源码
wget https://www.haproxy.org/download/2.0/src/haproxy-2.0.33.tar.gz
# 解压
tar -zxvf haproxy-2.0.33.tar.gz
cd haproxy-2.0.33

# 编译配置(开启常用功能:TLS、systemd、PCRE2正则、多线程)
make TARGET=linux-glibc USE_OPENSSL=1 USE_PCRE2=1 USE_SYSTEMD=1 USE_ZLIB=1

# 安装到系统
sudo make install

# 验证安装
haproxy -v
常用命令
haproxy 服务常用命令
# 开机自启
sudo systemctl enable haproxy

# 启动/停止/重启服务
sudo systemctl start haproxy
sudo systemctl stop haproxy
sudo systemctl restart haproxy

# 平滑重载配置(生产环境首选,不中断业务)
sudo systemctl reload haproxy

# 查看运行状态
sudo systemctl status haproxy

# 进程全局信息(版本、运行时长、全局连接统计)
echo "show info" | socat stdio /var/run/haproxy.sock

# 全部 proxy/server 统计
# 常用字段:1=proxy名 2=server名 5=当前连接scur 6=最大smax 8=总连接stot 9/10=进出流量bin/bout 18=状态
echo "show stat" | socat stdio /var/run/haproxy.sock
echo "show stat" | socat stdio /var/run/haproxy.sock | cut -d ',' -f1,2,5,6,8,9,10,18

# 后端节点详细状态(weight、maxconn、当前连接、状态、慢启动进度)
echo "show servers state kwbase_cluster" | socat stdio /var/run/haproxy.sock

# 列出所有 backend / listen 名称
echo "show backend" | socat stdio /var/run/haproxy.sock

# 最近请求/响应错误(排障必查)
echo "show errors" | socat stdio /var/run/haproxy.sock

# 当前活动会话
echo "show sessions" | socat stdio /var/run/haproxy.sock
Haproxy 常用命令参数
haproxy 命令行常用参数如下:
| 参数 | 说明 |
|---|---|
-v | 查看版本号 |
-vv | 查看版本号及编译选项(确认是否开启 TLS、systemd、PCRE2 等特性) |
-c | 仅检查配置文件语法,不启动进程,配置变更前必做 |
-f <file> | 指定配置文件,可多次指定以加载多个配置文件 |
-d | 前台调试模式运行,输出详细日志,用于排障 |
-db | 前台模式运行(不进入 daemon) |
-D | 以 daemon 模式后台运行 |
-q | quiet 静默模式,减少输出 |
-V | verbose 详细输出模式 |
-p <file> | 指定 PID 文件 |
-n <limit> | 进程级最大连接数限制(可覆盖配置中的 maxconn) |
-L <name> | 设置实例名称,配合 -x 平滑重载时识别新旧进程 |
-sf <pid1,pid2,...> | 启动新进程并平滑停止指定 PID 的旧进程(优雅退出,不中断连接) |
-st <pid1,pid2,...> | 启动新进程并立即停止指定 PID 的旧进程 |
-x <unix_socket> | 从旧进程继承现有连接,实现无缝热升级 |
::: Notes 说明
生产环境配置变更推荐流程:
# 配置校验
haproxy -c -f haproxy.cfg
# 平滑重载(旧连接不中断)
systemctl reload haproxy
:::
配置
haproxy.cfg 配置
haproxy 2.0.33+ 适用的配置参数,可根据具体版本和实际场景进行调整。更加个性化的配置也可参考官方文档:
global
    log /dev/log len 4096 local2 info     # Ubuntu 默认 rsyslog 就监听 /dev/log
    # log 127.0.0.1 len 4096 local2 info   # 需要配置 UDP 514 syslog接收端, syslog 输出,info级别,默认 debug;单条日志最大4KB,默认 1024;最多支持两条
    chroot /var/lib/haproxy              # 更改当前目录并为启动进程设置超级用户权限,从而提高安全性
    daemon                               # 以守护进程的方式工作于后台
    nbthread 4                           # 最大线程数,建议等于 CPU 物理核数
    maxconn 4096                          # HAProxy 进程可接受的最大并发连接数
    spread-checks 5                       # 健康检查时间随机打散,单位百分比(0‑50),避免同时对后端节点发起健康检测
    user haproxy                        # 进程初始化完成后降权为普通用户运行
    group haproxy                        # 对应运行用户组
    pidfile /var/run/haproxy.pid          #  HAProxy 进程 PID 记录到 pidfile
    stats socket /var/run/haproxy.sock level admin mode 660 group haproxy # Unix 套接字,用于 socat 实时运维
    stats timeout 30s                    # 管理套接字空闲超时时间
    hard-stop-after 30s                   # systemctl reload 平滑重载的旧进程优雅退出逻辑

defaults
    mode tcp                             # 四层 TCP 模式,适配数据库原生协议
    log global                           # 继承全局日志配置
    option dontlognull                   # 不记录无数据空连接(端口扫描等),减少无效日志
    # option dontlog-normal              # 仅记录异常连接,高并发下可开启以大幅减少日志量

    timeout connect 5s                   # 与后端建立 TCP 握手的超时时间,超时自动切换下一节点
    timeout client 300s                  # 客户端侧空闲连接超时,长连接业务建议调大
    timeout server 300s                  # 后端侧空闲连接超时,建议与客户端保持一致
    timeout queue 60s                    # 后端连接打满时,请求排队等待的最长时间

    retries 1                            # 连接失败重试次数
    option redispatch                    # 节点故障时,自动将请求重分发到其他健康节点

    option tcpka                         # 同时开启客户端+后端侧 TCP Keepalive,探测僵死连接

listen kwbase-cluster
    bind 0.0.0.0:26261                   # 监听所有网卡的 26261 端口
    # bind 0.0.0.0:26258 maxconn 8000   # 单独限制本端口最大并发连接数,建议大于所有 server maxconn 总和
    # bind 0.0.0.0:26258 backlog 4096   # TCP 全连接队列长度,高并发接入场景调大

    # ---------- 负载均衡算法(三选一) ----------
    # roundrobin     #普通加权轮询,按权重依次分配新连接,动态算法,支持 slowstart、socat 改权重
    balance leastconn        # 【推荐长连接场景】优先分配给当前连接数最少的节点
    # balance source         # 源IP哈希:同一客户端IP始终访问同一节点,保证会话粘性


    # ---------- 会话粘性(可选) ----------
    # 基于客户端源IP绑定会话,同一IP固定访问同一节点,避免事务跨节点异常
    # 数据一致性敏感的业务用 source 粘性,吞吐优先的场景用 leastconn
    # stick-table type ip size 100k expire 30m  # 存储10万条IP映射,30分钟无访问自动过期
    # stick on src

    # ---------- 健康检查基础配置 ----------
    # option tcp-check                     # 开启四层TCP健康检查(默认仅探测端口连通性),在 server 处声明 check 则无需此处配置

    # ---------- 后端节点公共默认参数(批量生效到所有server) ----------
    default-server \
        check \                          # 开启健康检查
        inter 3000 \                     # 健康检查间隔 3000 毫秒(3秒)
        rise 2 \                         # 连续成功 2 次,标记节点恢复可用
        fall 3 \                         # 连续失败 3 次,标记节点下线剔除
        weight 1 \                       # 节点权重,数值越大分配连接越多
        maxconn 500 \                    # 单节点最大并发连接数,保护数据库不被打满
        slowstart 30s \                  # 节点恢复后30秒内缓慢增加流量,避免瞬间压垮
        on-marked-down shutdown-sessions # 节点标记故障时,主动断开该节点所有现有连接
        # rise-on-fail                   # 节点短暂抖动恢复后,仍需走完 rise 次数才切回流量

    # ---------- Kwbase 后端节点列表 ----------
    server kwbase1 127.0.0.1:26257
    server kwbase2 127.0.0.1:26258
    server kwbase3 127.0.0.1:26259
    server kwbase4 127.0.0.1:26260
    server kwbase5 127.0.0.1:26262


# ======================
# 可选:HAProxy 状态监控面板(需要监控haproxy时配置)
# ======================
listen stats
    bind 0.0.0.0:8085
    mode http
    stats enable
    stats uri /haproxy_stats            # 监控页面的 URL拼接……0.0.0.0:8085/haproxy_stats
    stats auth admin:Kwbase@2024        # 监控页面登录账号密码
    stats refresh 30s                   # 页面自动刷新间隔
    stats hide-version                  # 隐藏监控页面上的 HAProxy 版本信息
    acl local_net src 127.0.0.0/8       # 定义访问控制规则
    stats admin if local_net            # 仅本地/内网 IP 允许管理操作
日志配置:
配置 rsyslog 监听 UDP 并转发到文件
创建 /etc/rsyslog.d/49-haproxy.conf :
# 启用 UDP syslog 接收(HAProxy 通过 UDP 514 发送)
module(load="imudp")
input(type="imudp" port="514")

# 把 local2 facility(HAProxy 默认)写到独立日志文件
local2.*    /var/log/haproxy.log

# 同时把含 haproxy 关键字的日志也写一份,避免漏配 facility
:programname, startswith, "haproxy"   /var/log/haproxy.log
连接即会产生日志

配置校验
haproxy -c -f haproxy.cfg
启动
haproxy -f haproxy.cfg
停止
# 优雅停止
systemctl stop haproxy
# 或使用 PID 文件发送 SIGTERM
kill $(cat /var/run/haproxy.pid)
场景实践
正常三副本集群
配置示例
# ==================================================
# Kwbase 正常分布式数据库集群 HAProxy 配置
# 架构:标准三副本对等集群
# 协议:TCP 四层代理 | 端口:26261
# 适用:通用场景,无特殊优化需求
# ==================================================

global
    log /dev/log local2 info
    daemon
    nbthread 4
    maxconn 4000
    maxconnrate 200
    spread-checks 5
    hard-stop-after 30s
    user haproxy
    group haproxy
    pidfile /var/run/haproxy.pid
    stats socket /var/run/haproxy.sock level admin mode 660 group haproxy
    stats timeout 30s

defaults
    mode tcp
    log global
    option dontlognull
    timeout connect 5s
    timeout client 300s
    timeout server 300s
    timeout queue 60s
    retries 1
    option redispatch
    option tcpka

listen kwbase_cluster
    bind 0.0.0.0:26261 maxconn 3000
    balance leastconn
    default-server check inter 3000 rise 2 fall 3 weight 1 maxconn 600 slowstart 30s on-marked-down shutdown-sessions

    server kwbase1 127.0.0.1:26257 id 1
    server kwbase2 127.0.0.1:26258 id 2
    server kwbase3 127.0.0.1:26259 id 3
    server kwbase4 127.0.0.1:26260 id 4
    server kwbase5 127.0.0.1:26262 id 5


listen stats
    bind 0.0.0.0:8084
    mode http
    stats enable
    stats uri /haproxy_stats
    stats auth admin:Kwbase@2024
    stats hide-version
    stats refresh 30s
    acl local_net src 127.0.0.0/8
    stats admin if local_net
效果验证
连接均衡
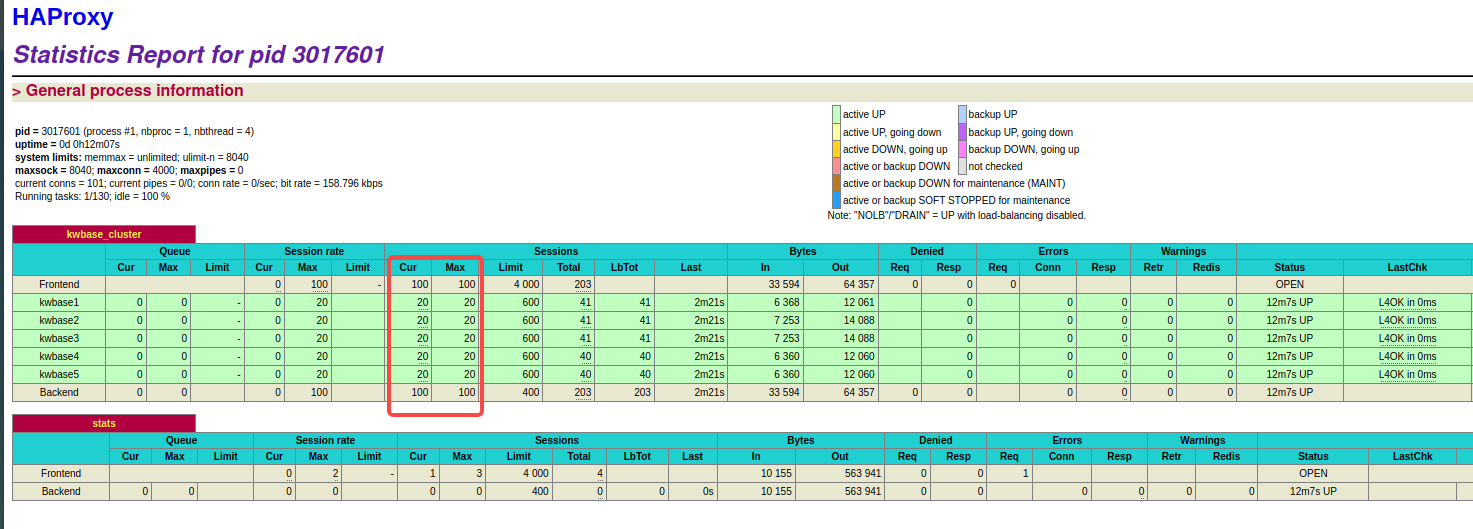
对于正常三副本分布式时序数据库集群,各节点对等,读写均衡,网络延迟正常(<10ms),无特殊压力或故障场景。配置的各项 server 权重均衡,采用 leastconn 连接算法,按当前连接数均匀分发流量。
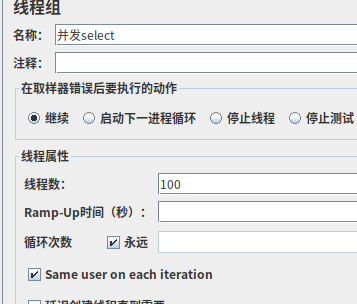
100 线程并发 select 的 jmeter,均衡分布在五节点执行
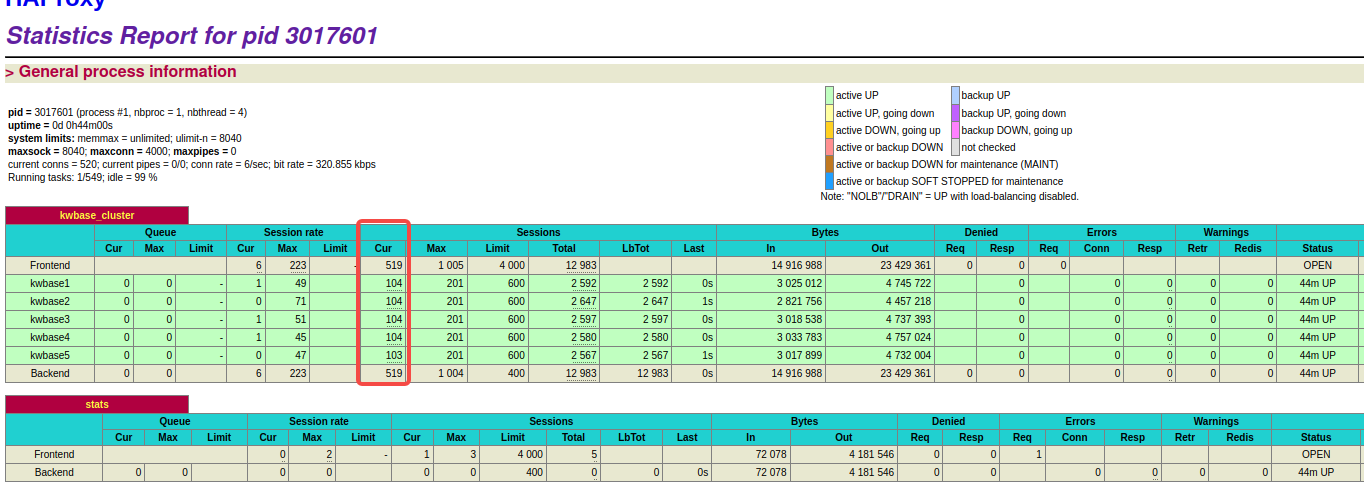
提高线程数量
故障节点
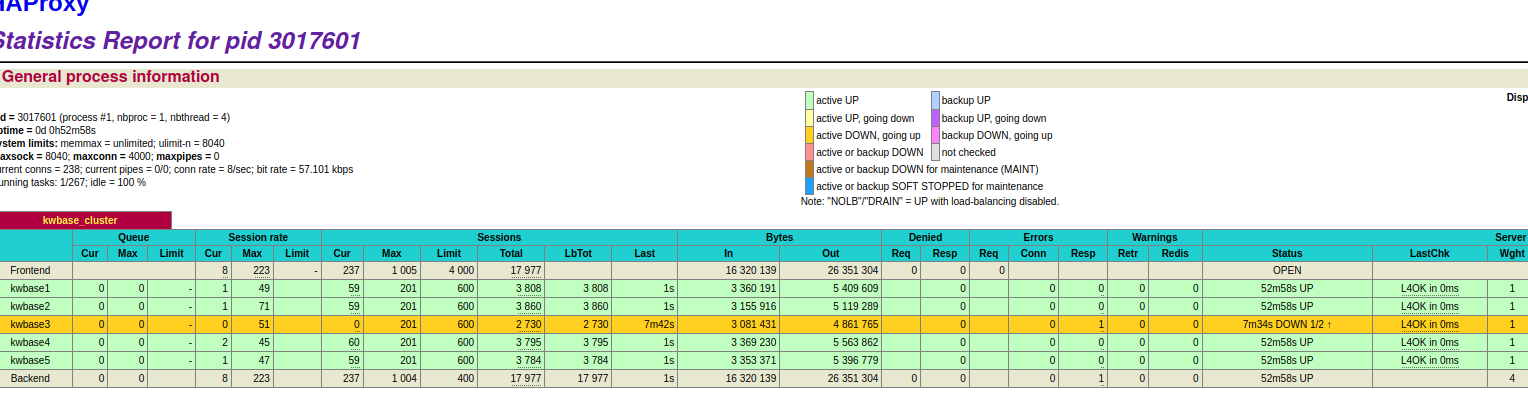
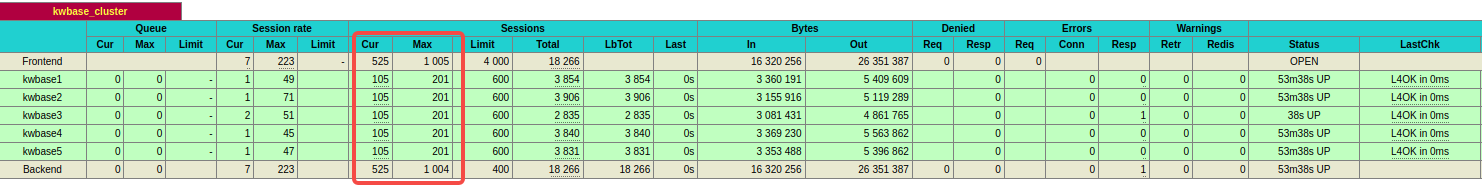
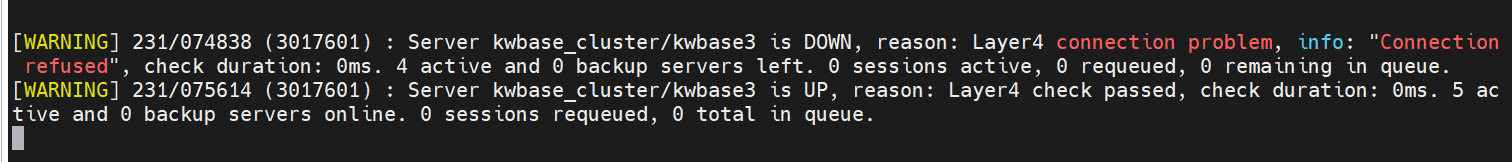
配置故障节点规则为失败三次标记为 DOWN,
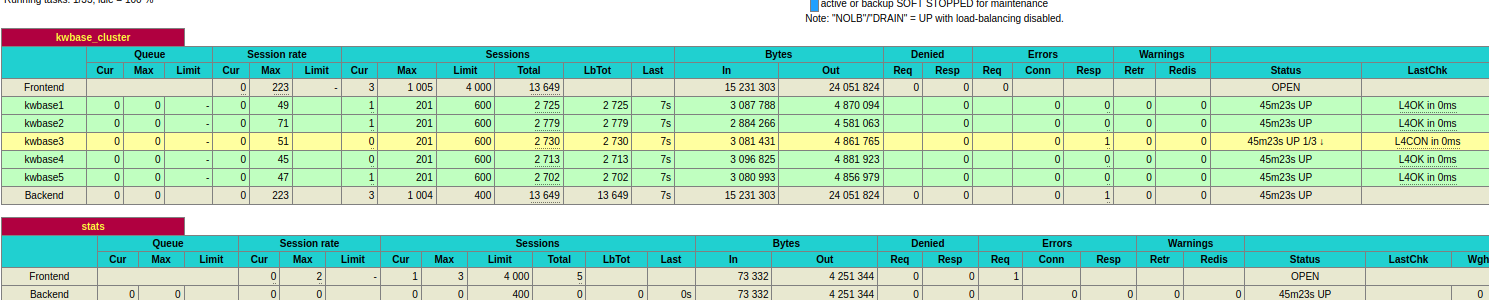
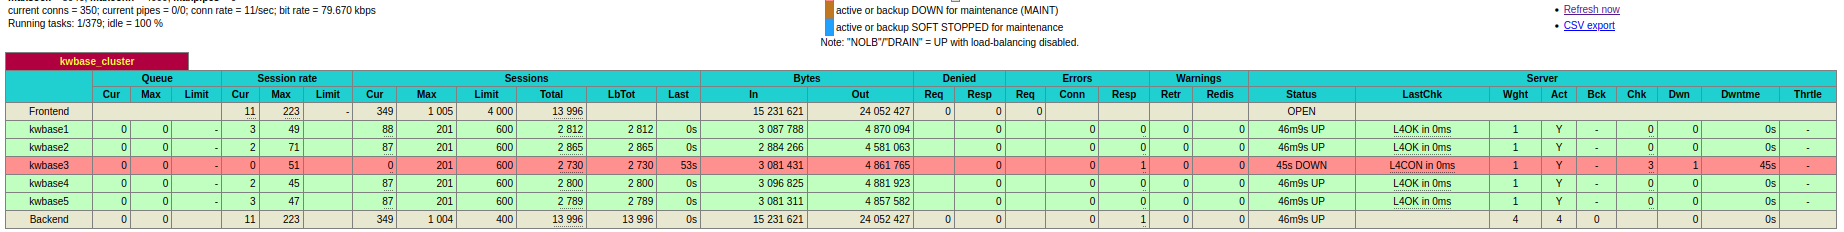
重启后成功两次重新 UP
单节点连接限制
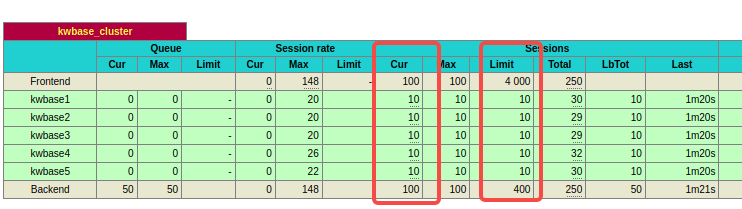
限制最大 10 连接,超过最大连接限制进入 queue 排队
双副本仲裁节点模式
双副本模式:集群采用 2 副本 + 1 仲裁节点(Arbiter),仲裁节点不存储数据、不参与读写,通常部署在性能较差的节点上,因此 haproxy 配置有如下特点:
仲裁节点
weight设为极低值,其他节点配置十倍以上,分配尽可能少的连接使用
leastconn策略保证读写连接稳定仲裁节点健康检查间隔可适当放宽(仲裁节点无实际数据压力)
配置示例
# ==================================================
# Kwbase 双副本(仲裁节点模式)HAProxy 配置
# 架构:2 数据副本 + 1 仲裁节点(无数据,仅投票)
# 协议:TCP 四层代理
# ==================================================

global
    log /dev/log local2 info
    daemon
    nbthread 4
    maxconn 4000
    maxconnrate 200
    spread-checks 5
    hard-stop-after 30s
    user haproxy
    group haproxy
    pidfile /var/run/haproxy.pid
    stats socket /var/run/haproxy.sock level admin mode 660 group haproxy
    stats timeout 30s

defaults
    mode tcp
    log global
    option dontlognull

    timeout connect 5s
    timeout client 300s
    timeout server 300s
    timeout queue 60s

    retries 1
    option redispatch
    option tcpka

listen kwbase_arbiter_replica
    bind 0.0.0.0:26261 maxconn 2000
    balance leastconn

    server data_node1 127.0.0.1:26258 id 1 weight 200 maxconn 800 check inter 3000 rise 2 fall 3 slowstart 30s on-marked-down shutdown-sessions
    server data_node2 127.0.0.1:26259 id 2 weight 200 maxconn 800 check inter 3000 rise 2 fall 3 slowstart 30s on-marked-down shutdown-sessions
    server arbiter_node 127.0.0.1:26257 id 3 weight 2 maxconn 10 check inter 10000 rise 1 fall 5 slowstart 60s on-marked-down shutdown-sessions


listen stats
    bind 0.0.0.0:8084
    mode http
    stats enable
    stats uri /haproxy_stats
    stats auth admin:Kwbase@2024
    stats refresh 30s
    stats hide-version
    acl local_net src 127.0.0.0/8
    stats admin if local_net
效果验证
权重流量分配验证
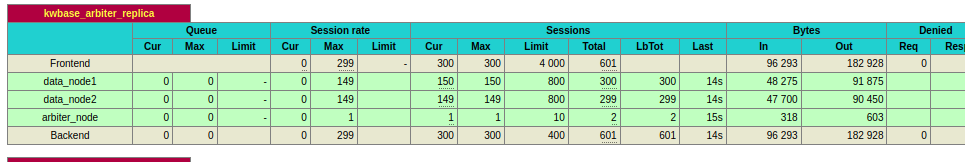
仲裁节点分配权重较低,99%以上连接全部分配在 data_node1 和 data_node2 节点上;
仲裁节点只分配一个连接,几乎不接受业务流量。
单数据节点故障验证
一个数据节点 DOWN,jmeter200 线程,分给另一个数据节点
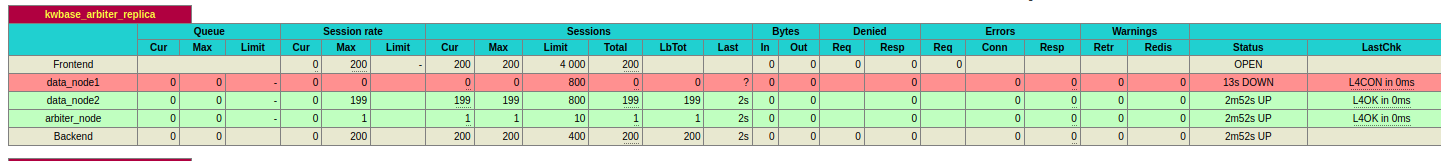
重启后 check 两次视为 UP
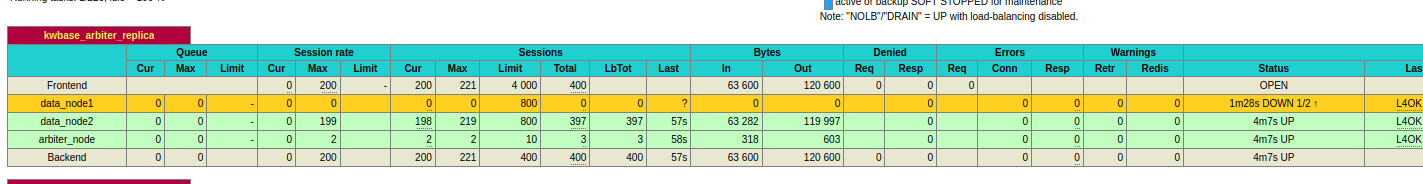
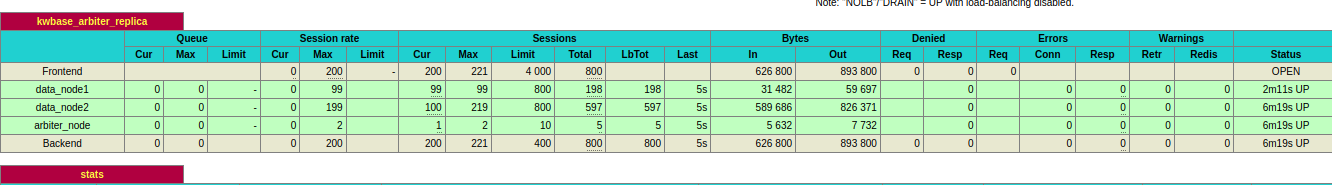
后续新建连接,恢复故障前分配
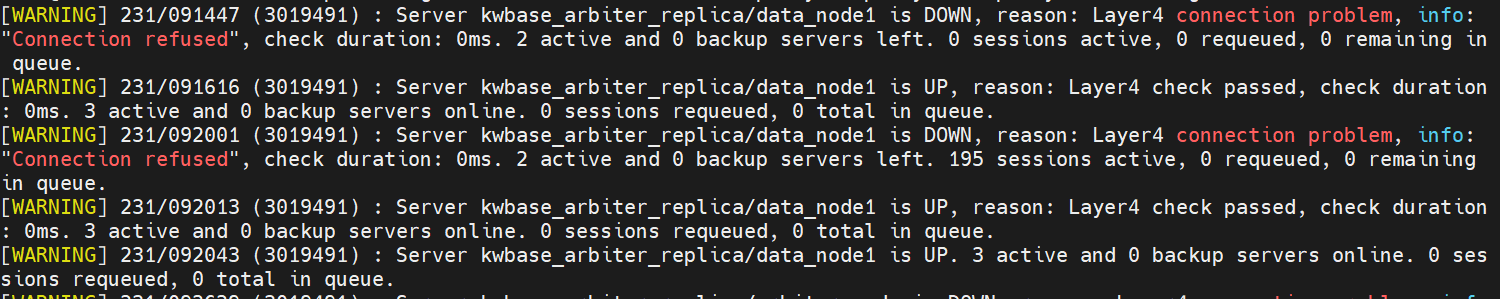
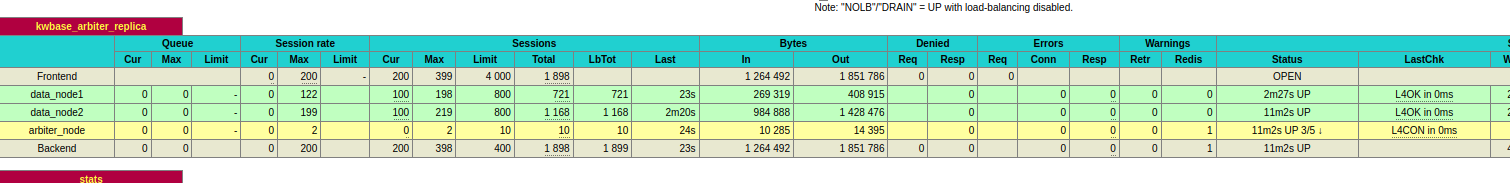
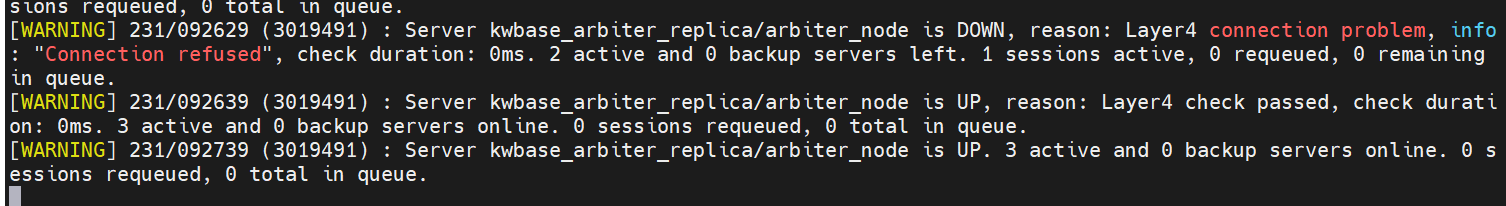
仲裁节点短暂离线
由于配置仲裁节点校验间隔为 10s,5 轮次后才标记为 DOWN,因此短暂时间内恢复节点即可重新 UP

网络高延迟波动场景
当网络延迟超过 50ms 且波动较大,需要保持连接稳定性,以及超时时长适当延长
- 增大超时容忍度:
timeout connect调大,以及timeout client和timeout server - 降低健康检查频率,提高 check 时长
- 对于延迟不同的后端采用不同的
weight,分配连接数量区别
配置示例
# ==================================================
# Kwbase 网络高延迟波动场景 HAProxy 配置
# 架构:分布式多节点集群,网络延迟 >50ms/100ms,波动较大
# 核心目标:最大化连接稳定性,最小化超时丢连接
# ==================================================

global
    log /dev/log local2 info
    daemon
    nbthread 8
    maxconn 4000
    maxconnrate 200
    spread-checks 10
    hard-stop-after 60s
    user haproxy
    group haproxy
    pidfile /var/run/haproxy.pid
    stats socket /var/run/haproxy.sock level admin mode 660 group haproxy
    stats timeout 60s

defaults
    mode tcp
    log global
    option dontlognull

    timeout connect 15s
    timeout client 600s
    timeout server 600s
    timeout queue 120s

    retries 1
    option redispatch
    option tcpka


listen kwbase_high_latency
    bind 0.0.0.0:26261

    balance leastconn

    default-server check inter 10000 rise 3 fall 4 weight 2 maxconn 1000 slowstart 60s on-marked-down shutdown-sessions


    server kwbase_dc1_1 127.0.0.1:26257 id 1
    server kwbase_dc1_2 127.0.0.1:26258 id 2
    server kwbase_dc1_3 127.0.0.1:26259 id 3
    server kwbase_dc2_1 127.0.0.1:26260 id 4 weight 1
    server kwbase_dc2_2 127.0.0.1:26262 id 5 weight 1


listen stats
    bind 0.0.0.0:8084
    mode http
    stats enable
    stats uri /haproxy_stats
    stats auth admin:Kwbase@2024
    stats refresh 30s
    acl local_net src 127.0.0.0/8
    stats admin if local_net
    stats hide-version
效果验证
连接均衡验证
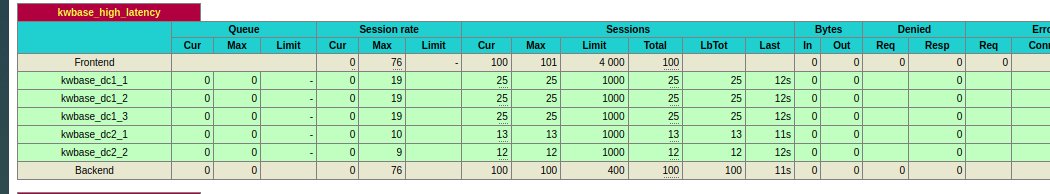
对网卡增加 100ms 延迟和 5% 丢包后,开启 jmeter 执行查询,如图结果
建立连接后,会按照指定的权重值分配不同 server 的连接数量
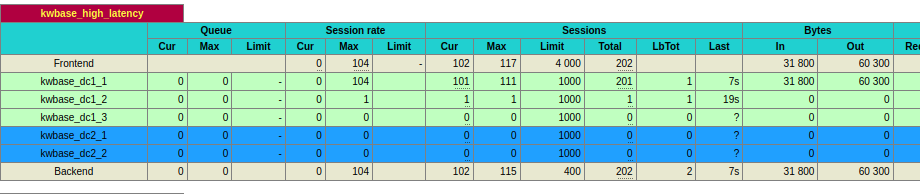
若开启 stick-table type ip,效果如下图,相同源ip的连接会连到同一个 server,缺点是可能会导致连接倾斜不均衡
增加延迟情况下验证连接稳定
timeout server 与 timeout client 设置较小时,本地建立的长连接在对应时间内未交互则会被断开并重新连接,连接的后端也会漂移。因此设置 timeout client 600s、timeout server 600s
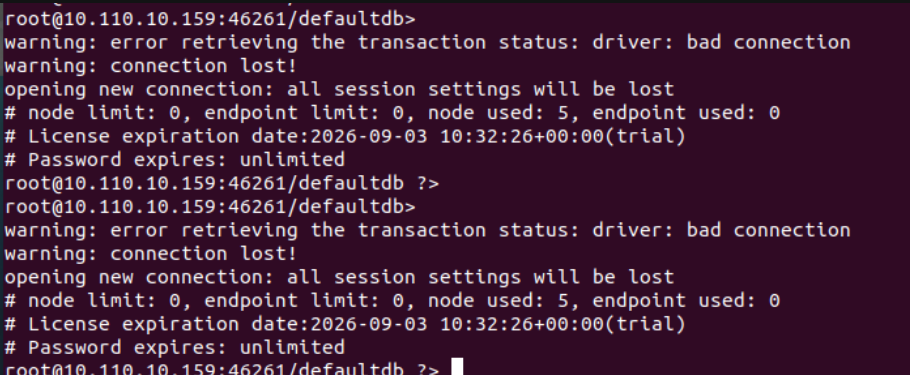
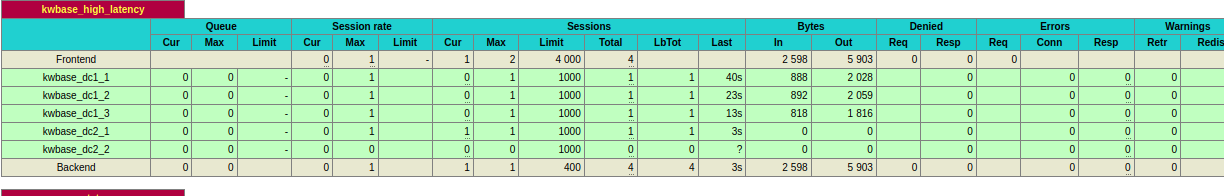
对网卡增加延迟和丢包,观察连接面板稳定

网络波动误判
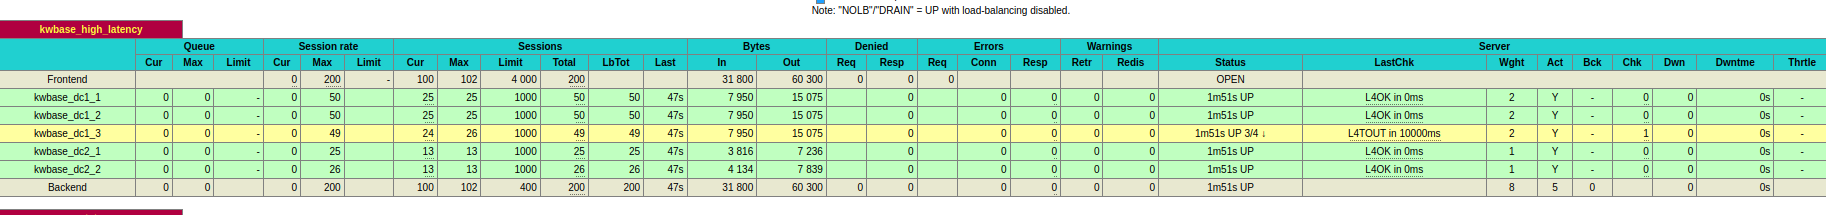
将某个端口阻塞一段时间模拟网络波动,观察到需要经过四次 10s 的 check 才划定为 DOWN,在尚未标记为 DOWN 恢复端口网络后,连接重新 UP
三副本高压力写入
高压力写入场景下,核心配置如下:
提高
maxconn和单节点maxconnleastconn策略:写入场景连接数优先分配,保证各节点负载均衡读写分离,查询和写入通过不同的 listen 端配置到不同的后端
配置示例
# ==================================================
# Kwbase 高压力写入场景 HAProxy 配置
# 架构:分布式时序数据库集群,写入为主要负载
# 核心目标:最大化写入吞吐,防止连接堆积,保证写入一致性
# ==================================================

global
    log /dev/log local2 info
    daemon
    nbthread 16
    maxconn 4000
    maxconnrate 200
    spread-checks 5
    hard-stop-after 15s
    user haproxy
    group haproxy
    pidfile /var/run/haproxy.pid
    stats socket /var/run/haproxy.sock level admin mode 660 group haproxy
    stats timeout 30s

defaults
    mode tcp
    log global
    option dontlognull
    option dontlog-normal
    timeout connect 3s
    timeout client 120s
    timeout server 120s
    timeout queue 30s
    retries 1
    option redispatch
    option tcpka

listen kwbase_write_cluster
    bind 0.0.0.0:26260 maxconn 3000
    balance leastconn
    default-server check inter 2000 rise 2 fall 3 weight 1 maxconn 600 slowstart 20s on-marked-down shutdown-sessions

    server kwbase_write1 127.0.0.1:26257 id 1
    server kwbase_write2 127.0.0.1:26258 id 2
    server kwbase_write3 127.0.0.1:26259 id 3
    server kwbase_write4 10.0.1.14:26262 id 4
    server kwbase_write5 10.0.1.15:26263 id 5

listen kwbase_read_cluster
    bind 0.0.0.0:26261 maxconn 1000
    balance leastconn
    default-server check inter 3000 rise 2 fall 3 weight 1 maxconn 300 slowstart 30s on-marked-down shutdown-sessions

    server kwbase_read1 127.0.0.1:26257 id 1
    server kwbase_read2 127.0.0.1:26258 id 2
    server kwbase_read3 127.0.0.1:26259 id 3

listen stats
    bind 0.0.0.0:8084
    mode http
    stats enable
    stats uri /haproxy_stats
    stats auth admin:Kwbase@2024
    stats refresh 15s
    acl local_net src 127.0.0.0/8
    stats admin if local_net
    stats hide-version
效果验证
读写分离
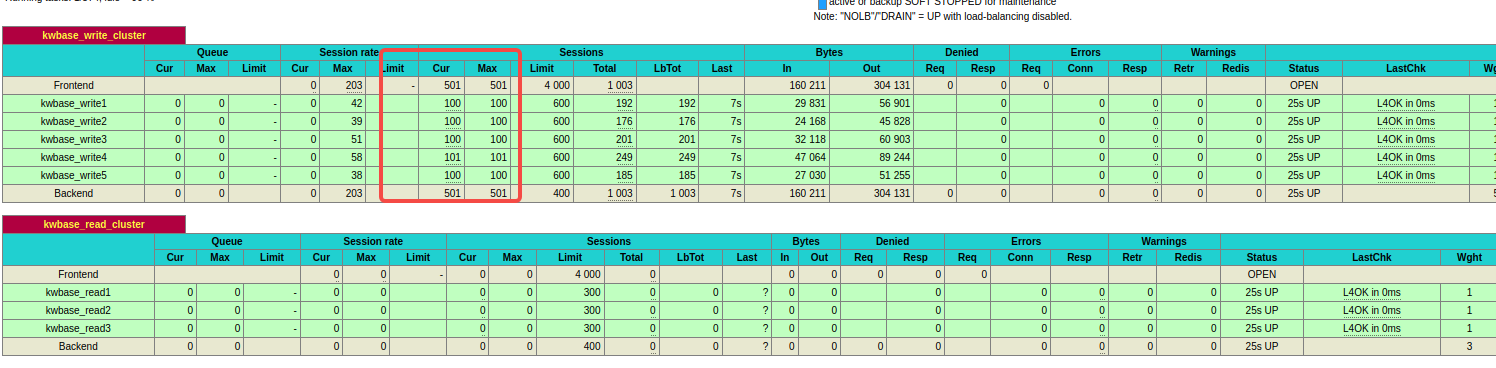
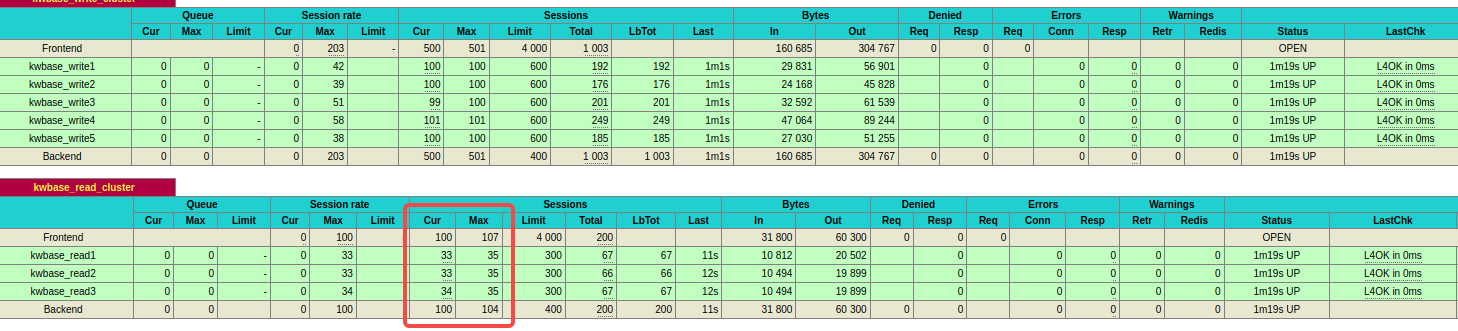
两个 jmeter 分别对写入端口和查询端口执行操作,观察状态面板,查询和写入分别根据定义的 leastconn 进行均衡连接,两组连接互不干扰,实现读写流量分层治理。
开启 500 并发写入后,暂不开启查询
开启 100 并发查询
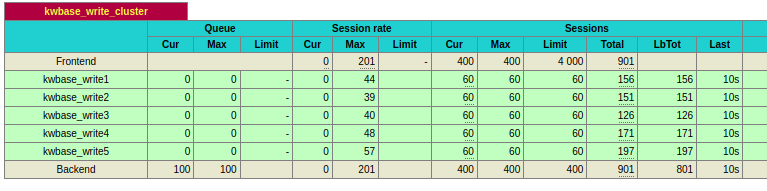
单节点限制连接数
jmeter 不便发压过大并发,改小单个 server 限制为 60,jmeter 发压 400 并发写入
观察到超过的 100 连接进入队列
listen kwbase_write_cluster
    bind 0.0.0.0:26260 maxconn 400
    balance leastconn
    default-server check inter 2000 rise 2 fall 3 weight 1 maxconn 60 slowstart 20s on-marked-down shutdown-sessions

    server kwbase_write1 127.0.0.1:26257 id 1
    server kwbase_write2 127.0.0.1:26258 id 2
    server kwbase_write3 127.0.0.1:26259 id 3
    server kwbase_write4 127.0.0.1:26262 id 4
    server kwbase_write5 127.0.0.1:26263 id 5
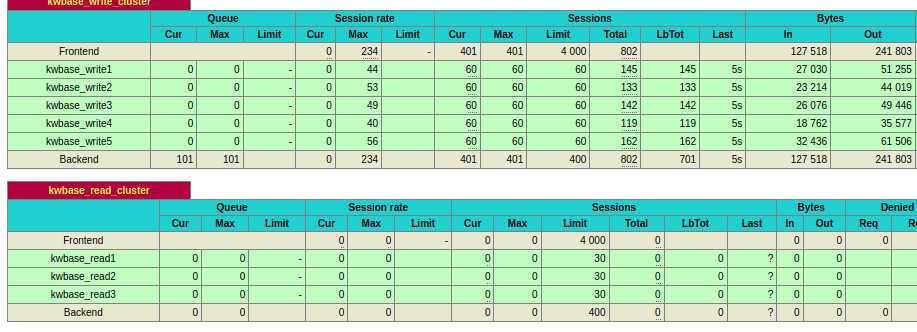
继续增加 jmeter 并发超过写入 maxconn,写入 500 并发,但是执行中的为 300 并发,queue 中 100
观察写入堆积 queue 仅有 100,不会堆积大量的写入