KaiwuDB Benchmark
KaiwuDB Benchmark 是一款专为 KaiwuDB 数据库设计的性能基准测试工具,支持高并发批量数据写入与查询两大核心功能。用户通过简单的 JSON 配置文件定义测试参数(如线程数、数据结构、写入/查询规则等),即可快速执行性能测试并生成结构化结果报告,适用于评估 KaiwuDB 在不同业务场景下的吞吐量、延迟等核心性能指标。
功能特性
- 多场景测试支持
- 写入测试
- 支持时序/非时序数据写入,可配置并发线程数、批次提交量、模拟设备总数、每个设备的数据量数据乱序比例。
- 支持定义数据时间戳的起始时间与数据生成间隔,精确控制时间序列。
- 查询测试
- 支持多线程并发查询自定义 SQL 语句,自动统计查询延迟与吞吐量。
- 支持查询全部设备、指定单个设备的最新一行或最新一列的数据。
- 支持查询全部设备,指定单个设备、指定多个设备在特定时间窗口内的数据。
- 支持对全表或指定设备在特定时间段进行聚合计算(
COUNT、SUM、AVG、MIN、MAX)。
- 写入测试
- 灵活的配置能力:通过 JSON 文件统一配置测试参数,包括:
- 数据库连接信息(如主机、端口、用户名、密码等)
- 测试类型(写入测试/查询测试)、并发线程数
- 表结构定义(如字段类型、标签、主键)、数据生成规则(时间戳范围、乱序比例)
- 测试结果输出路径
- 多维度性能统计
- 写入测试:写入数据总量、写入并发数、写入吞吐量(行/秒)、执行耗时;最大/最小/平均延迟。
- 查询测试:查询总次数、每秒查询量(QPS)、最大/最小/平均延迟。
工作原理
KaiwuDB Benchmark 通过配置驱动和多线程并发的方式模拟真实业务场景,实现对 KaiwuDB 数据库的性能测试。下图说明 KaiwuDB Benchmark 的核心工作原理:

指定测试配置文件路径:用户指定测试配置文件的路径。
解析与校验:KaiwuDB Benchmark 解析命令行参数,校验配置文件路径并启动测试流程。
读取配置:KaiwuDB Benchmark 读取配置文件,解析数据库连接信息、测试类型、并发参数、数据生成规则等内容。
准备环境:KaiwuDB Benchmark 根据配置信息,自动创建数据库(时序库/普通库)和表,确保测试环境的一致性。
执行测试任务。
- 写入测试:KaiwuDB Benchmark 按规则生成随机数据(支持时间戳乱序),批量插入数据并记录每个线程的执行指标。
- 查询测试:KaiwuDB Benchmark 循环执行自定义 SQL 语句,控制查询间隔,记录每次查询的耗时与结果。
生成报告:KaiwuDB Benchmark 汇总所有线程的执行数据,计算吞吐量、延迟等关键指标,并输出可视化报告。
参数说明
| 参数 | 说明 |
|---|---|
-V/--version | 显示版本信息并退出。 说明: 不能与其他参数混用。 |
-?/--help | 显示帮助信息并退出。 说明: 不能与其他参数混用。 |
配置文件说明
KaiwuDB Benchmark 支持 insert(写入测试)和 query(查询测试)两种类型。用户需要分别通过 JSON 文件统一配置对应的测试参数。
通用配置
下表列出写入测试和查询测试均适用的配置参数。
| 参数 | 类型 | 说明 | 必选项 | 示例值 |
|---|---|---|---|---|
type | String | 测试类型,取值为 insert 或 query | 是 | insert |
host | String | KaiwuDB 数据库的 IP 地址 | 是 | 127.0.0.1 |
port | Int | KaiwuDB 数据库的端口号 | 是 | 26257 |
user | String | KaiwuDB 数据库的用户名 | 是 | test |
password | String | KaiwuDB 数据库的密码 | 是 | Password@123 |
cert_auth | Boolean | 是否启用证书认证 | 是 | false |
cert_path | String | 证书路径 | 否 | /home/kaiwudb/certs |
cert_type | String | 安全协议类型,取值为 TLS 或 TLCP | 否 | tls |
threads | Int | 并发线程数 | 是 | 10 |
result_file | String | 结果输出文件路径,默认不输出执行过程和执行结果到文件。 | 否 | /home/kaiwuDB/file/result.txt |
records_per_req | Long | 数据入库周期(默认1s),单个设备产生的数据总数。 | 否 | 1000 |
prepared_rand | Long | 批量插入数据行数时,产生的随机时间数量。 | 否 | 50 |
protocol_ext | String | 写入扩展协议: - prepare_ext:通过prepare扩展协议写入数据。- off:默认值。查询扩展协议: 支持的值: lz4:传输数据通过lz4 压缩解压。snappy:传输数据通过snappy 压缩解压。off:不适用压缩算法,默认值。 | 否 | off |
insert_method | String | 插入数据方式: - insert:insert批量写入方式。- prepare:prepare批量写入方式。- prepare_ext:通过prepare扩展协议写数据。说明: protocol_ext 和 prepare_ext两个参数,只要有一个参数设置为prepare_ext,就开启扩展协议写数据。 | 否 | off |
batch_interval | Int | 自定义 Insert 批次之间的时间间隔,单位为毫秒。 | 否 | - |
query_times | Int | 单线程查询次数。该参数仅适用于 query 类型。 | 否 | 10 |
query_interval | Long | 两次查询的时间间隔,单位毫秒。该参数仅适用于 query 类型。 | 否 | 1000 |
query_showcount | Boolean | 是否显示查询结果行数。 | 否 | true |
database | Object | 数据库配置(嵌套参数) | 否 | - |
写入测试配置
本节列出写入测试适用的配置参数。
database 节点配置
database 节点配置用于定义目标数据库的相关参数。下表列出 database 节点的配置参数。
| 参数 | 类型 | 说明 | 必选项 | 示例值 |
|---|---|---|---|---|
name | String | 数据库的名称 | 是 | test_db |
engine | String | 可选值:tsdb:时序引擎,默认值,也可使用 timeseries 。rdb:关系引擎,也可用 relation。 | 是 | tsdb |
drop | Boolean | 测试前是否删除重建数据库,默认为 false。 | 是 | false |
table | Object | 表结构配置(嵌套参数) | 是 | - |
table 节点配置
table 节点配置用于定义表结构创建与数据生成规则。下表列出 table 节点的配置参数。
| 参数 | 类型 | 说明 | 必选项 | 示例值 |
|---|---|---|---|---|
name | String | 表名 | 是 | meters |
device_prefix | String | 设备 ID 前缀 | 是 | dev |
device_count | Int | 设备总数 | 是 | 100 |
device_rows | Int | 单设备写入行数 | 是 | 96369 |
batch_size | Int | 批量插入行数 | 是 | 1000 |
ts_start | String | 起始时间戳,格式为 yyyy-MM-dd HH:mm:ss | 是 | 2025-09-01 00:00:00 |
ts_step | Long | 时间戳递增步长(单位:毫秒) | 是 | 1 |
insert_interval | Long | 数据入库频率(单位:毫秒) | 是 | 1000 |
disorder_ratio | Int | 时间戳乱序比例(百分比,0-100)。取值为 0 时,表示不启用乱序功能。该参数仅适用于时序表。 | 是 | 10 |
disorder_range | Array | 乱序时间范围,格式为 [min,max](单位:毫秒)。该参数仅适用于时序表。 | 是 | [0, 50] |
type | String | 表类型。只有当 engine 为 tsdb 时生效。支持的值:- spare:稀疏时序表,每个设备写入的测点数最好不超过 4096。- dense:普通时序表,测点最多为 4096,所有设备所有测点均需要写入数据。 | 是 | dense |
sparsity | Array | 稀疏表的稀疏性配置,即设备及其测点的分布情况,表示一部分设备(device_num)只写其中一部分测点(metric_num),device_num 之和等于 device_count,metric_num 之和小于等于 columns 配置的列数之和,否则报错。 | 否 | - |
columns | Array | 字段配置(嵌套参数) | 是 | - |
tags | Array | 标签配置。该参数仅适用于时序表。 | 否 | - |
sparsity 节点配置
sparsity用于定义稀疏表的稀疏性配置,下表列出 sparsity 节点的配置参数。
| 参数 | 类型 | 说明 | 必选项 | 示例值 |
|---|---|---|---|---|
device_num | Int | 稀疏表设备的数量 | 否 | 4 |
metric_num | Int | 稀疏表设备对应的测点数量 | 否 | 7 |
说明
device_num为4,metric_num为7,表示4个设备只写其中的7个测点列。
columns 节点配置
下表列出每个 table 节点配置中的 columns 节点的配置参数。
说明
对于时序表,默认包含 ts 字段(TIMESTAMPTZ 类型),因此用户无需在 columns 节点中重复定义该字段。
| 参数 | 类型 | 说明 | 必选项 | 示例值 |
|---|---|---|---|---|
name | String | 字段名 | 是 | p1 |
type | String | 字段类型 | 是 | int4 |
non_null | Boolean | 是否非空,取值为 true 或者 false | 否 | false |
min | Int | 随机值最小值。该参数仅适用于数值类型。 | 否 | 0 |
max | Int | 随机值最大值。该参数仅适用于数值类型。 | 否 | 100 |
values | Array | nchar/binary 列/标签的值域,将从值中随机选择。 | 否 | ["beijing","tianjin"] |
len | Int | 指定该数据类型的长度,对 CHAR、VARCHAR、NCHAR 数据类型有效。如果对其它数据类型配置了该参数,若为0,则代表该列始终都是 null 值写入,如果不为 0 则被忽略。 | 否 | 16 |
encode | String | 设置列的编码算法,设置为 disabled 表示关闭该列的编码,如未指定,使用该类型的默认编码算法。不同数据类型支持的编码算法参考存储管理 | 否 | - |
compress | String | 设置列的压缩,支持 lz4、zstd、zlib、snappy,大小写不敏感。设置为 disabled 表示关闭列的压缩,默认使用 lz4。 | 否 | lz4 |
level | String | 设置压缩算法的压缩级别,必须紧跟在 compress 之后指定,大小写不敏感,支持 low(简写l)、high(简写h)、medium(简写m,默认值)。压缩级别越高,压缩率越高。但所需资源与耗时也会增加。除 snappy 和 lz4 外,其他压缩算法均可设置压缩级别。如果 compress 设置为 disabled,指定该参数会报错。 | 否 | m |
tags 节点配置
当写入数据表为时序表时,用户需要配置 tags 节点信息。下表列出每个 table 节点配置中的 tags 节点的配置参数。
说明
对于时序表,第一个标签列类型必须是 VARCHAR 类型,且第一个标签列必须是主标签并设置为非空列。标签列的值是由设备 ID 前缀(device_prefix)和设备 ID 拼接组成,例如 dev1、dev2、dev3。
| 参数 | 类型 | 说明 | 必选项 | 示例值 |
|---|---|---|---|---|
name | String | 标签名 | 是 | location |
type | String | 标签类型(支持字符串、数值等) | 是 | VARCHAR(20) |
primary | Boolean | 是否为主键标签 | 否 | false |
non_null | Boolean | 是否非空 | 否 | false |
values | Array | 标签可选值 [a,b,c] 中随机选取。该参数仅适用于非设备 ID 标签。 | 非设备 ID 标签时必选 | ["Tianjin","Beijing"] |
len | Int | 指定该数据类型的长度,对 CHAR、VARCHAR、NCHAR 数据类型有效。如果对其它数据类型配置了该参数,若为0,则代表该列始终都是 null 值写入,如果不为 0 则被忽略。 | 否 | 16 |
min | Int | 随机值最小值。该参数仅适用于数值类型。 | 否 | 0 |
max | Int | 随机值最大值。该参数仅适用于数值类型。 | 否 | 100 |
查询测试配置
本节列出查询测试适用的配置参数。
database 节点配置
database 节点配置用于定义目标数据库的相关参数。下表列出 database 节点的配置参数。
| 参数 | 类型 | 说明 | 必选项 | 示例值 |
|---|---|---|---|---|
name | String | 数据库的名称 | 是 | test_db |
sqls | Array | 查询 SQL 配置 | 是 | - |
query_sql 节点配置
sqls 节点配置用于支持多组 SQL 语句的并行查询。下表列出 sqls 节点的配置参数。
说明
sqls 节点配置中的 query_times和 query_interval 参数的优先级大于 database 节点下对应参数的优先级。如果 sqls 节点配置参数存在,则使用 sqls 节点配置参数。如果不存在,则使用上级节点的配置参数。
| 参数 | 类型 | 说明 | 必选项 | 示例值 |
|---|---|---|---|---|
tablename | String | 查询表的名称 | 是 | meters |
sql | String | 查询 SQL 语句 | 是 | select last_row(*) from meters |
query_times | Int | 单线程执行次数 | 否 | 10 |
query_interval | Long | SQL 语句执行间隔(单位:毫秒) | 否 | 1 |
支持的数据类型
| 类型 | 名称 | |
|---|---|---|
| 数值类型 | 整数类型 | TINYINT/UTINYINT SMALLINT/USMALLINT INT/UINT BIGINT/UBIGINT |
| 浮点类型 | FLOAT/DOUBLE | |
| 布尔类型 | BOOL | |
| 字符类型 | BINARY/VARBINARY(仅时序支持) CHAR//NCHAR/VARCHAR |
使用举例
本节说明如何运行 KaiwuDB Benchmark 基准测试工具,进行写入测试和查询测试。
前提条件
- 联系 KaiwuDB 技术支持人员,获取 KaiwuDB Benchmark 安装包。
- 安装 KaiwuDB 数据库、配置数据库认证方式、创建数据库。
- 创建具有表级别及以上操作权限的用户。
写入测试示例
准备写入测试配置文件。
以下是写入测试配置文件(
insert_config.json)示例。该写入测试示例启动 10 个线程,平均分配 100 台设备,每个线程负责 10 台设备,根据配置的时间戳和递增步长,批量写入数据。说明
写入数据总量 = device_count * device_rows;
{
  "type": "insert",
  "host": "127.0.0.1",
  "port": 26257,
  "user": "test",
  "password": "Password@2024",
  "cert_auth": false,
  "cert_path": "/etc/kaiwudb/certs",
  "cert_type": "tls",
  "threads": 10,  // 并发写入线程数
  "result_file": "/kwdb-benchmark/file/insert_result.txt",  // 结果输出路径
  "insert_method": "prepare-ext", // prepare扩展协议写入
  "batch_interval": 0, // 多批次INSERT之间的时间间隔
  "prepared_rand": 50, // 批量插入数据时,产生的随机时间数量
  "protocol_ext": "prepare-ext",
  "records_per_req": 200, // 数据入库周期内,单个设备产生的数据总数
  "database": {
    "name": "test_db",  // 目标数据库名称
    "engine": "tsdb",  // 启用时序数据库模式
    "drop": true,  // 测试前删除并重建数据库(确保环境清洁)
    "table": {
      "name": "meters",  // 目标表名
      "type": "sparse", // 表类型,可选sparse(稀疏表)、dense(普通时序表)
      "device_prefix": "dev",  // 设备ID前缀(生成设备标识为dev1~dev100)
      "device_count": 100,  // 设备总数
      "device_rows": 100,  // 单设备写入行数
      "batch_size": 100,  // 批量插入行数(每100行执行一次SQL)
      "ts_start": "2025-09-17 13:00:00.000",  // 起始时间戳
      "ts_step": 1,  // 时间戳递增步长(毫秒)
      "insert_interval": 1000,  // 数据入库频率(毫秒)
      "disorder_ratio": 10,  // 时间戳乱序比例(10%的数据随机偏移,最大为 100%)
      "disorder_range": [0, 50],  // 乱序时间范围(0~50毫秒)
      "sparsity": [
            {
                "device_num": 40,
                "metric_num": 3
            },
            {
                "device_num": 50,
                "metric_num": 6
            },
            {
                "device_num": 10,
                "metric_num": 1
            }
        ],
      "columns": [  // 表字段配置(含类型及取值范围)
        {"name": "p1", "type": "BOOL"},
        {"name": "p2", "type": "INT", "min": 10, "max": 100,"encode": "simple8b", "compress": "lz4", "level": "medium"},
        {"name": "p3", "type": "INT", "min": 100, "max": 2000},
        {"name": "p4", "type": "BIGINT", "values": [ 1001, 1002, 1003 ]},
        {"name": "p5", "type": "FLOAT"},
        {"name": "p6", "type": "BOOL", "encode": "bit-packing", "compress": "lz4", "level": "medium"},
        {"name": "p7", "type": "INT"},
        {"name": "p8", "type": "FLOAT"},
        {"name": "p9", "type": "BIGINT"},
        {"name": "p10", "type": "DOUBLE"}
      ],
      "tags": [  // 时序表标签配置(时序库必需)
        {
          "name": "device",
          "type": "VARCHAR",
          "primary": true,  // 主键标签(唯一标识设备)
          "len": 16,
          "non_null": true
        },
        {
          "name": "location",
          "type": "VARCHAR",
          "primary": false,
          "len": 20,
          "non_null": false,
          "values": ["TianJin", "BeiJing", "ShangHai", "JiNan"]  // 标签可选值(随机选取)
        }
      ]
    }
  }
}
说明
以下配置示例表示,40个设备写3个测点,50个设备写6个测点,10个设备写1个测点,所有设备的
device_num之和等于device_count,所有设备写入的总测点数小于等于columns配置的列数之和。"sparsity": [ { "device_num": 40, "metric_num": 3 }, { "device_num": 50, "metric_num": 6 }, { "device_num": 10, "metric_num": 1 } ]赋予KaiwuDB Benchmark 安装包执行权限,然后运行以下命令。
./kwdbBenchmark -f insert_test.json执行完成后,KaiwuDB Benchmark 会先删除并重建数据库,然后创建时序表,再启动多线程批量写入数据。写入完成后,KaiwuDB Benchmark 将统计结果打印到命令行输出日志,并写入由
result_file参数指定的文件中。以下是写入测试结果示例:[09/14 07:50:49.548662] INFO: spent 100.704314 (real 0.016876) seconds to insert rows: 10000 with 10 thread(s) into testdb 99.30 (real 592557.48) records/second [09/14 07:50:49.548684] INFO: insert delay, min: 0.1110ms, avg: 0.1688ms, p90: 0.2160ms, p95: 0.2360ms, p99: 0.2750ms, max: 0.3600ms
查询测试示例
准备查询测试配置文件。
以下是查询测试配置文件(
query_config.json)示例。该查询测试示例执行两条 SQL 查询语句。第一个查询语句执行 10次,两次查询间隔 1 毫秒。第二条查询语句执行 15 次查询。{ "type": "query", "host": "127.0.0.1", "port": 26257, "user": "test", "password": "Password@2024", "cert_auth": false, "cert_path": "/etc/kaiwudb/certs", "cert_type": "tls", "threads": 10, // 默认并发线程数(可被SQL级配置覆盖) "result_file": "/kwdb-benchmark/file/query_result.txt", // 结果输出路径 "query_times": 10, // 默认单线程查询次数(可被SQL级配置覆盖) "query_interval": 1, // 默认查询间隔(毫秒,可被SQL级配置覆盖) "query_showcount": false, //是否显示查询结果行数 "protocol_ext": "off", //查询扩展协议,支持snappy、lz4、off(不开启) "database": { "name": "test_db", // 目标数据库名称(与写入测试的数据库一致) "sqls": [ // 待执行的查询SQL列表 { "tablename": "meters", // 表名 "query_times": 10, // 执行次数(覆盖默认值) "query_interval": 1, // 两次查询间隔(毫秒,覆盖默认值) "sql": "select last_row(*) from xxxx" // 查询表中最新数据 }, { "tablename": "", // 表名 "query_times": 15, // 执行次数 "sql": "select count(*) from testdb.meters where device='dev1'" // 统计指定设备的数据量 } ] } }进入安装包目录,然后运行以下命令。
./kwdbBenchmark -f query_config.json执行完成后,KaiwuDB Benchmark 连接已创建的数据库,启动多线程循环执行指定的 SQL 查询语句。查询完成后,系统将 QPS、延迟等指标打印到命令行输出日志,并写入由
result_file参数指定的文件中。以下是查询测试结果示例:[09/14 09:04:21.486436] INFO: spend 0.032584s using 10 threads complete query 250 times, min delay: 0.000711s, avg delay: 0.000846s, p90: 0.000966s, p95: 0.001033s, p99: 0.001198s, max: 0.001604s [09/14 09:04:21.486462] INFO: spend 0.881000 seconds completed total queries: 250, the QPS of all threads: 283.7684其中,
QPS表示总查询次数 / 总执行时间,反映 KaiwuDB 数据库的查询吞吐量。Min delay或Max delay表示最小/最大查询耗时,反映查询响应速度。
常见问题
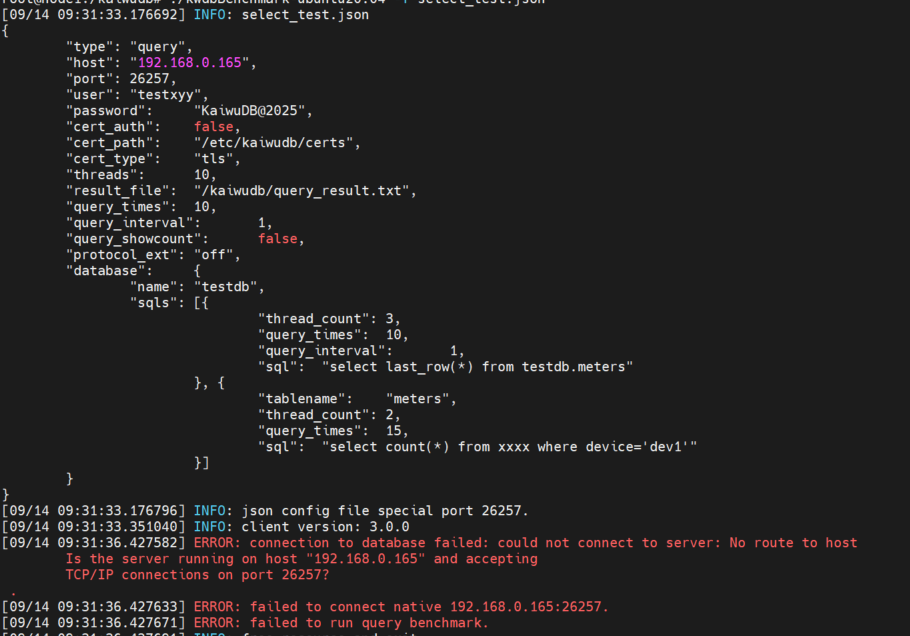
1、数据库连接异常
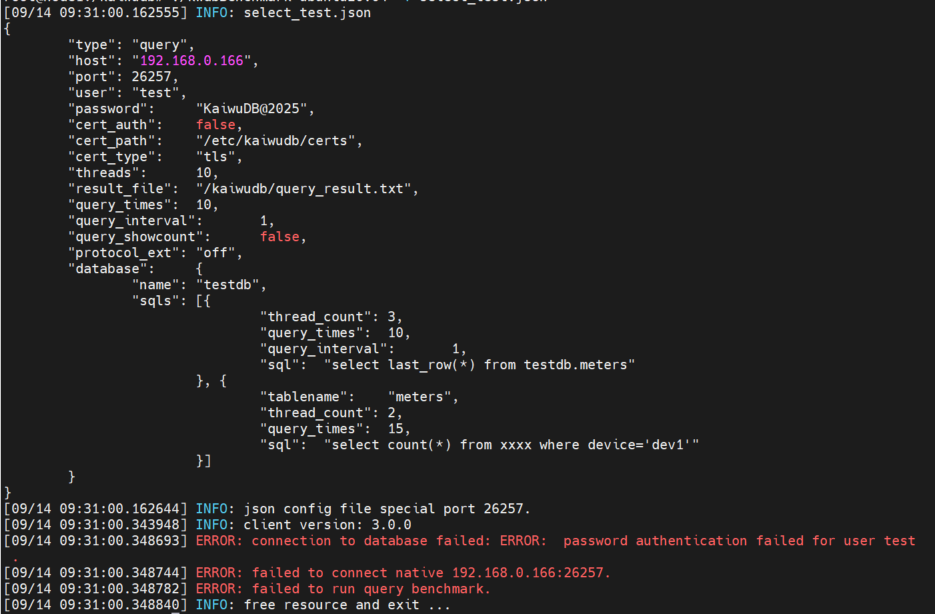
2、用户密码校验失败
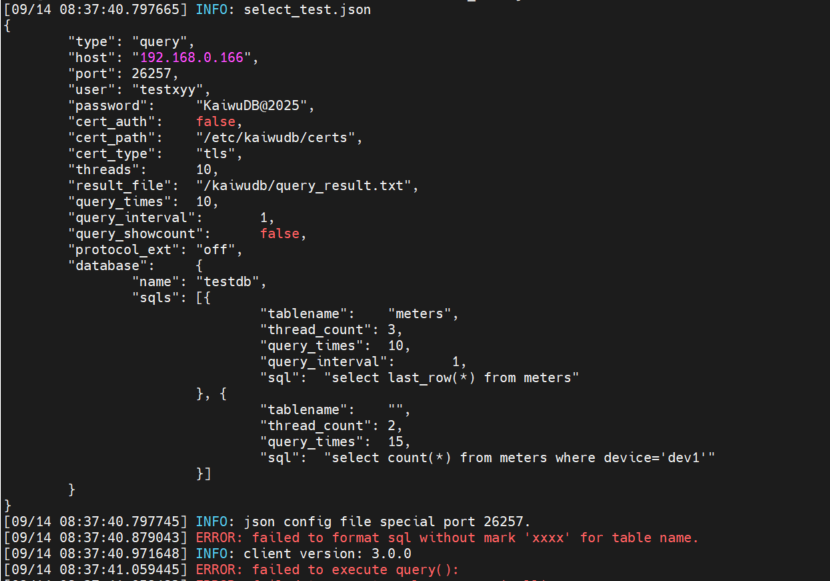
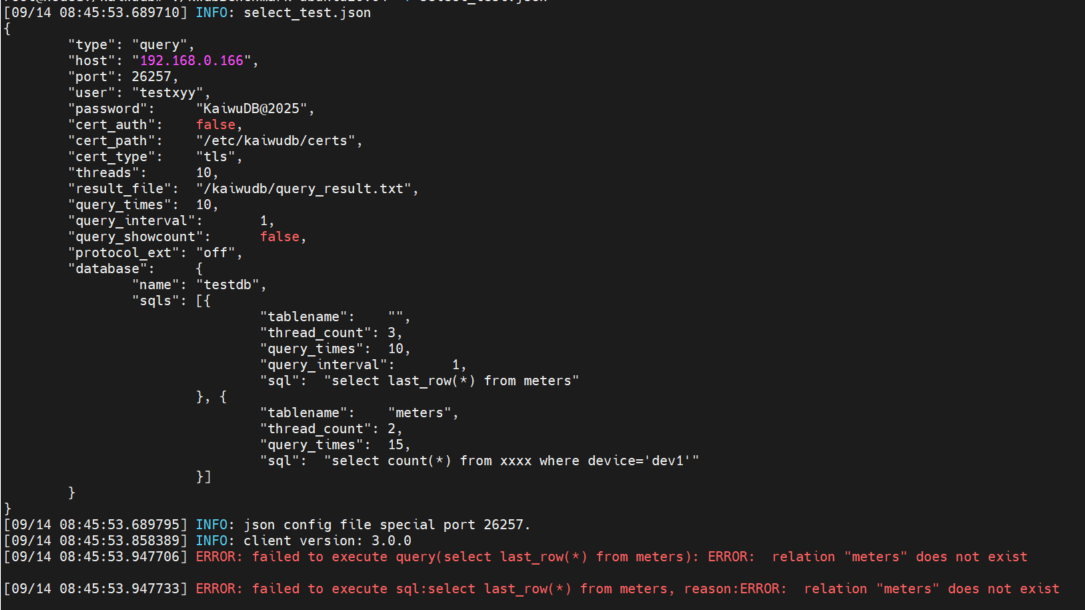
3、参数冲突
说明
- 当sql语句中的table_name为具体表名时,参数
tablename为空或者不配置该参数,但是此时需要在 sql 中写为 dbname.tablename,否则就会从默认库 defaultdb 下寻找 tablename。 - 当参数
tablename为具体表名时,此时会从参数database.name读取 dbname,sql 中表名的位置需要使用xxxx代替。